
向量 Embeddings
向量模型用于语义检索、相似度计算和 RAG 等场景。它使用独立的模型类型与请求入口,不是 Chat 请求中的一种输出模式。
配置向量模型
Section titled “配置向量模型”- 为供应商配置 OpenAI
embeddings端点,或 Geminimodels.embed端点。 - 导入或创建输出模态为
embedding的模型,核对输入 Token 单价。 - 创建对应的请求入口与上游目标,填写供应商实际模型名。
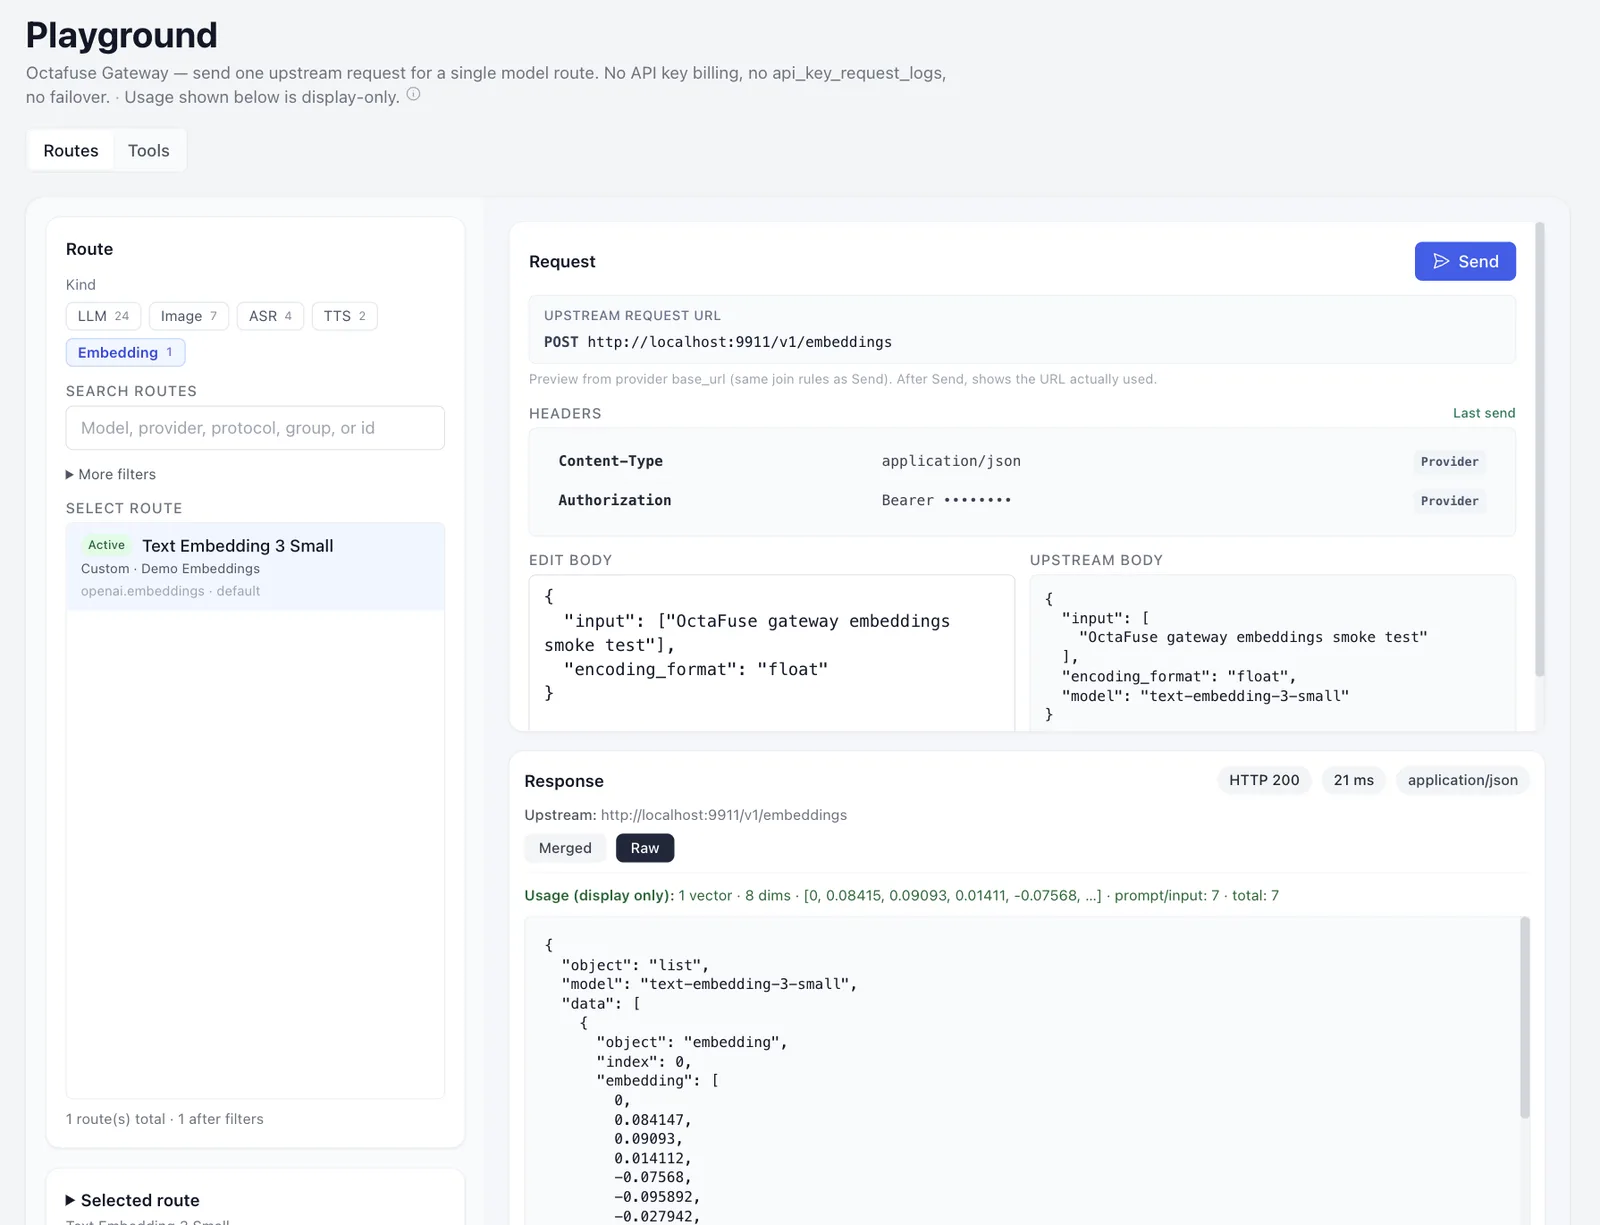
- 在调试台试算向量,核对向量数量和维度;再通过模拟器验证真实路由和记账。
OpenAI 兼容调用
Section titled “OpenAI 兼容调用”curl -sS http://localhost:8787/v1/embeddings \ -H 'Authorization: Bearer sk-your-api-key' \ -H 'Content-Type: application/json' \ -d '{"model":"your-embedding-model","input":["hello","world"]}'dimensions 和 encoding_format 等参数由上游模型解释。向量请求同样使用路由池、故障转移和限流;网关只按上游报告的输入 Token 计费,上游缺少用量时不计费。
Gemini 与模型发现
Section titled “Gemini 与模型发现”Gemini 使用 :embedContent 或 :batchEmbedContents,请求体按原生协议发送。默认 GET /v1/models 不包含向量,发现向量模型请使用 ?kind=embedding 或 ?kind=all。
完整请求与计费约定见 向量 API 参考。