
语音与实时音频
语音识别(ASR)把音频转为文本;语音合成(TTS)把文本转为音频。同步文件、异步任务和实时会话的端点与计费方式不同,应分开配置。
选择客户端入口
Section titled “选择客户端入口”| 场景 | 接入方式 |
|---|---|
| OpenAI 兼容文件转写 | /v1/audio/transcriptions,选择可用的透传或转换适配器 |
| OpenAI 兼容语音合成 | /v1/audio/speech,按上游配置 voice 与输出格式 |
| DashScope 原生识别、合成或异步任务 | 对应 DashScope 请求入口;异步提交与查询按支持的任务协议组合 |
| MiniMax、ElevenLabs 原生能力 | 对应已实现的原生入口,按厂商请求格式调用 |
| 实时识别或合成 | 支持的 DashScope / ElevenLabs WebSocket 原生路径 |
实时路径不代表支持所有厂商的语音对语音模型,也不提供通用的 OpenAI Realtime 转换。
- 为供应商启用所需音频端点,导入 ASR 或 TTS 模型。
- 根据模型系列选择适配器,检查上传文件、公网音频 URL、流式输出等限制。
- 核对计费单位:识别可能按秒或 Token,合成可能按字符或 Token,以该模型配置为准。
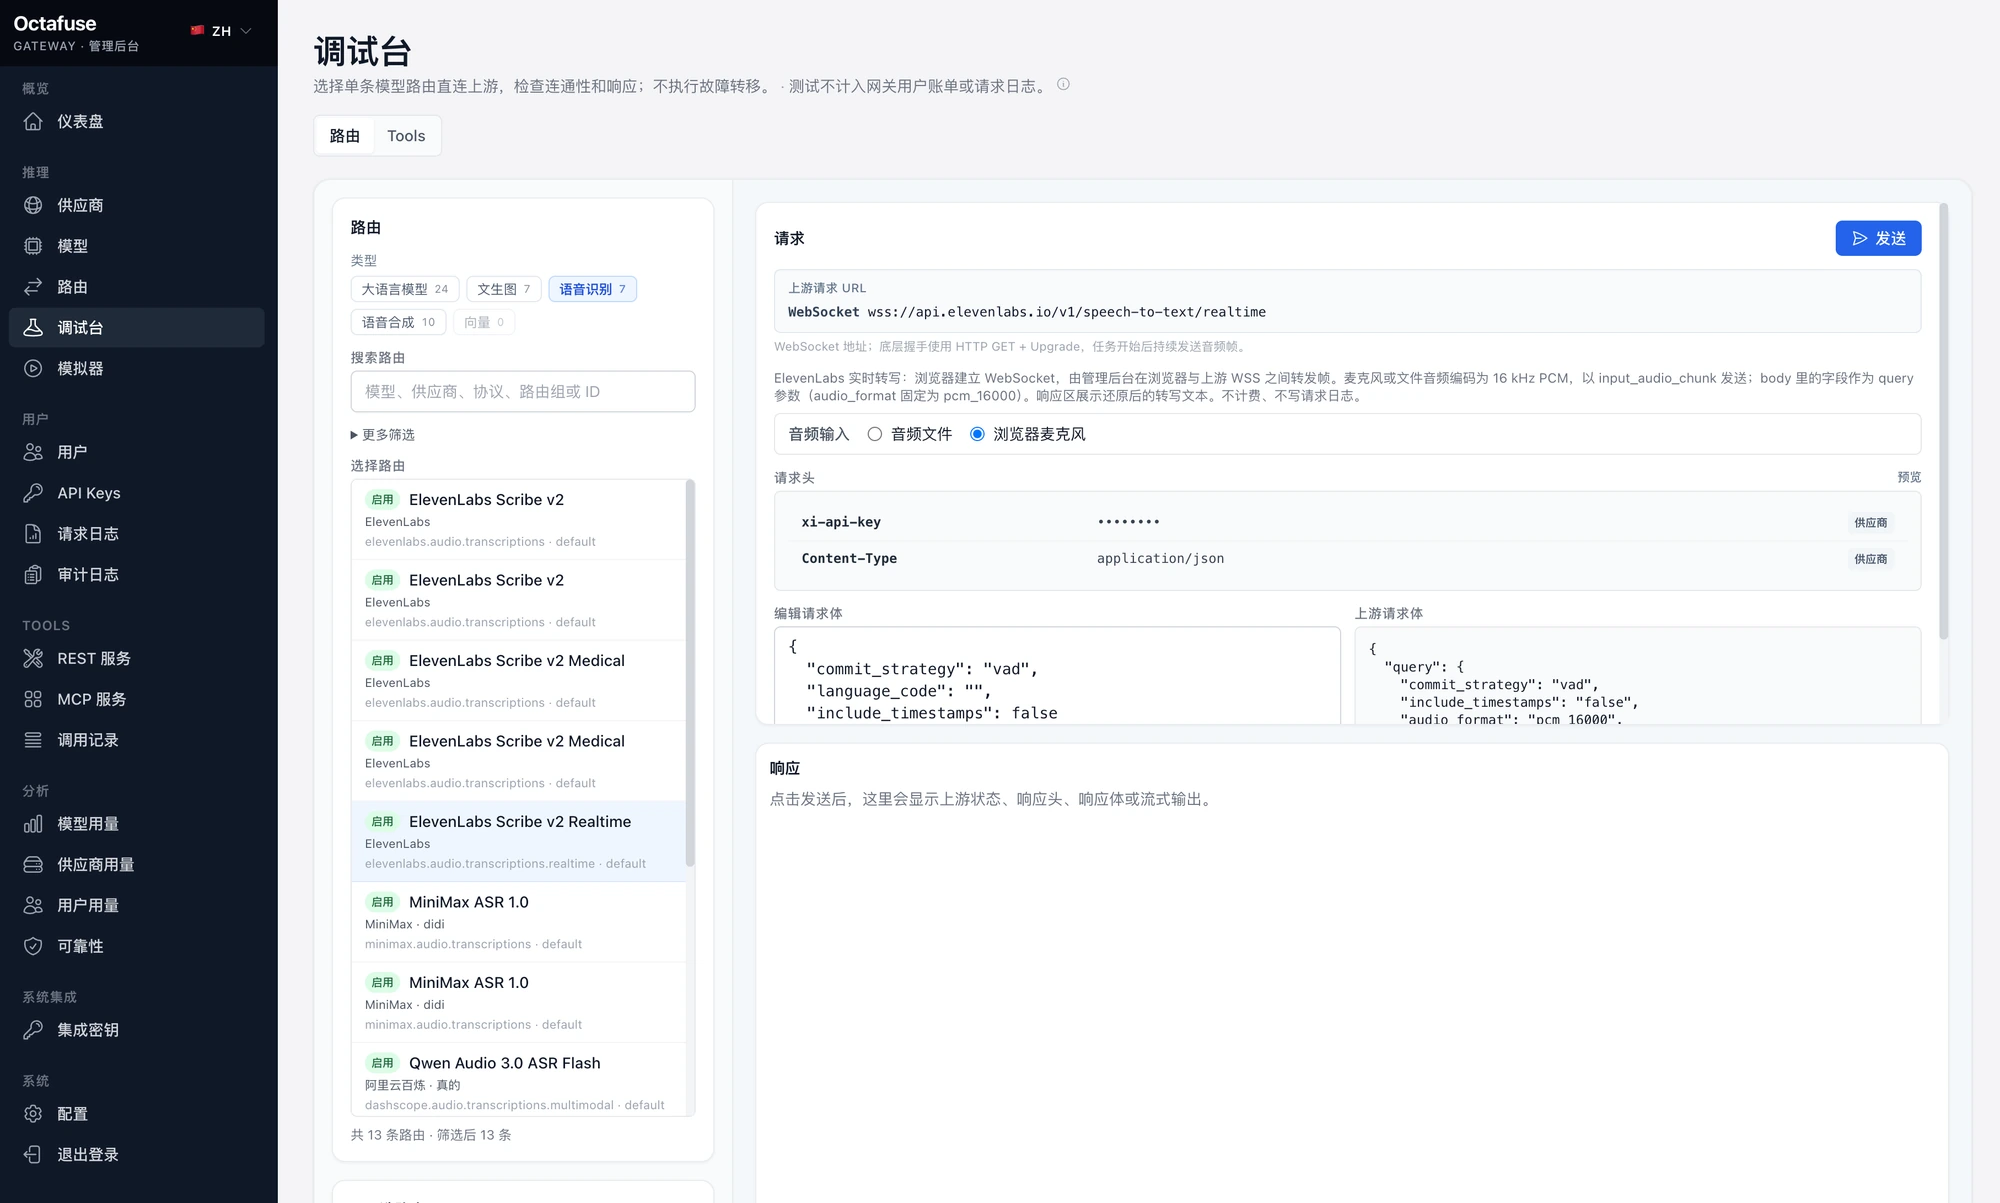
- 使用调试台验证响应;实时 ASR 可按支持情况使用浏览器麦克风。
- 使用模拟器或真实客户端验证用户鉴权、实际用量、额度与请求日志。
语音合成示例
Section titled “语音合成示例”curl -sS http://localhost:8787/v1/audio/speech \ -H 'Authorization: Bearer sk-your-api-key' \ -H 'Content-Type: application/json' \ -d '{"model":"your-tts-model","input":"你好,OctaFuse。","voice":"your-voice"}' \ --output speech.mp3列表分别使用 kind=asr 和 kind=tts;kind=audio 同时列出两者。预设没有列出的厂商功能不能据此视为网关已支持。